実験データとカタログスペックの見方-1
これはHigh Performance Computingのシリーズ連載の一部です。
このブログで話すこと
このブログは主に実験データを見たときに何を考えるべきかを書きます。これは実験データの計測結果の妥当性を考えるために必要です。計測結果が本当にこの計測値で良いのかをデータシートのカタログスペックと照らし合わせながら検証する方法を扱います。
ハードウェアのスペック
| Machine | NVIDIA GH200 |
| CPU FP32 FLOPS | 7.1 TFLOPS(計算値) |
| CUDA FP32 FLOPS | 67 TFLOPS |
| Tensor Core FP32 FLOPS | 494 TFLOPS |
| CPU Memory Bandwidth | Up to 512GB/s |
| GPU Memory Bandwidth | 4.0 TB/s |
ハードウェアのスペック値から考察する
以下の議論では簡単のため, 行列積を扱うことにしましょう。正方行列$A, B, C \in \mathbb{R}^{N \times N}$が与えられた時に行列積を考えます。
\[C = AB\]$N = 512$の時にNaiveな行列積, Numpyの行列積, PyTorchの行列積, PyTorchの行列積でTensor Coreを使ったものの結果は以下の通りとなりました。精度は全てFP32のもので, 使用したコードはMaterialsにあります(run_all.shで実行)
| 手法 | 結果 (ms) |
|---|---|
| CPU (Naive) | 93.81 |
| CPU (Numpy) | 1.576e-01 |
| GPU (Non Tensor Core) | 1.723e-02 |
| GPU (Tensor Core) | 1.304e-02 |
さて結果からわかることはなんでしょうか?まずNaiveなCPUコードは最も遅いです。これはプログラミングを学びたてのFreshmenでも書けるような簡単なコードです。これは以下のようなコードとなっています。この記事では扱いませんがここから改善するためにloop unrolling, tiling, SIMD, shared memory, tensor coreというような手法で他の手法は高速化されています。
void matmul(int n, const float *A, const float *B, float *C) {
    for (int i = 0; i < n; i++)
        for (int j = 0; j < n; j++) {
            float sum = 0.0f;
            for (int k = 0; k < n; k++) sum += A[i * n + k] * B[k * n + j];
            C[i * n + j] = sum;
        }
}
さて本題です。確かにNaiveなCPU MatmulよりもCPU (Numpy)は早く見えます。しかしながらこの結果は最適なのでしょうか?要するに, この結果はハードウェアの性能を十分に引き出していますか?
| 手法 | 結果 (ms) |
|---|---|
| CPU (Naive) | 93.81 |
| CPU (Numpy) | 1.576e-01 |
| GPU (Non Tensor Core) | 1.723e-02 |
| GPU (Tensor Core) | 1.304e-02 |
1つの指標としては理論FLOPSを計算してみることでしょう, 行列積のFLOPsは$2N^3$ですから, それに基づいて計算すると
| 手法 | 結果 (ms) | GFLOPS |
|---|---|---|
| CPU (Naive) | 93.81 | 2.86 |
| CPU (Numpy) | 1.576e-01 | 1704 |
| GPU (Non Tensor Core) | 1.723e-02 | 15576 |
| GPU (Tensor Core) | 1.304e-02 | 20584 |
となります。確かにNaiveなCPU MatmulはCPUの理論FLOPS 7.1TFLOPSに対して0.040%の性能しか達成できていませんこれはハードウェアの性能を達成できていないと言ってよさそうです。それに対して他の結果はどうでしょうか?ハードウェアの性能を引き出せているでしょうか?この時点では答えはNoと答える方が多数派でしょう, CPU (Numpy)は理論FLOPS 7.1TFLOPSに対して24%, GPU (Non Tensor Core)は67 TFLOPSに対して23%, GPU (Tensor Core)は494 TFLOPSに対して4.2%しか達成できていません。これは何故でしょうか?実はNumpyもPyTorchも不十分な最適化が行われているのでしょうか?
Roofline
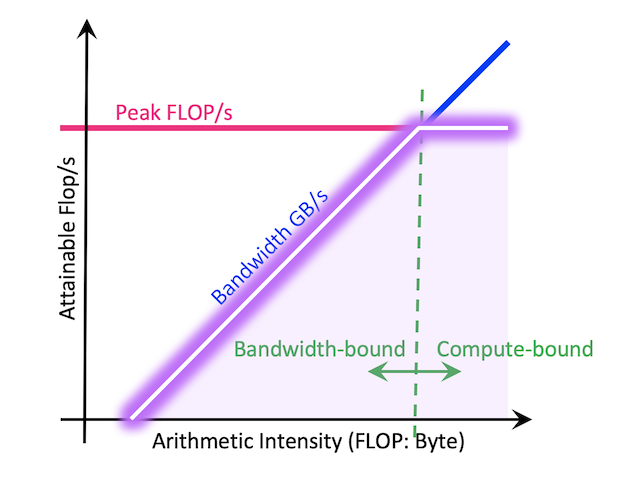 画像はNERSC Documentation [2]より取得
先ほどの疑問に答えるための道具がRooflineモデルです。カタログスペックに載っている「理論FLOPS」は, 演算器が休みなく動き続けた場合の値です。しかし実際のプログラムでは演算器に渡すデータをメモリから運んでこなければならず, そのデータ供給が間に合わなければ演算器は待たされてしまいます。Rooflineモデル [1] は, 計算の速さとデータを運ぶ速さのどちらが性能を律速するのかを1枚の図で示すモデルです。
Rooflineモデルの数式
まず以下の量を定義します。
- $W$ [FLOP]: プログラムが行う浮動小数点演算の回数
- $Q$ [Byte]: プログラムがメモリ(ここではRAM)との間で転送するデータ量
- $P_{\mathrm{peak}}$ [FLOP/s]: ハードウェアの理論FLOPS
- $B$ [Byte/s]: ハードウェアのメモリバンド幅
演算に必要な時間は少なくとも$W / P_{\mathrm{peak}}$, データ転送に必要な時間は少なくとも$Q / B$です。演算とデータ転送が理想的にオーバーラップしたとしても, 実行時間$T$はこの2つのうち遅い方を下回ることはできません。
\[T \geq \max\left(\frac{W}{P_{\mathrm{peak}}}, \frac{Q}{B}\right)\]達成FLOPS $P = W / T$に書き直すと
\[P \leq \min\left(P_{\mathrm{peak}}, \frac{W}{Q} \cdot B\right) = \min\left(P_{\mathrm{peak}}, I \cdot B\right)\]となります。ここで
\[I = \frac{W}{Q} \quad [\mathrm{FLOP/Byte}]\]は演算強度 (Arithmetic Intensity) と呼ばれ, 1 Byteのデータを運んでくる間に何回演算するかを表します。これがRooflineモデルの全てです。横軸に$I$, 縦軸に$P$を両対数でとると, 上限は傾き1の斜めの直線($I \cdot B$)と水平な直線($P_{\mathrm{peak}}$)を繋いだ屋根のような形になります。これがRoofline(屋根の線)という名前の由来です。
2本の線が交わる点
\[I^{*} = \frac{P_{\mathrm{peak}}}{B}\]をRidge Pointと呼びます。
- $I < I^{*}$ のプログラムはMemory Boundです。演算器をいくら速くしても性能は上がらず, 上限は$I \cdot B$で決まります。
- $I > I^{*}$ のプログラムはCompute Boundです。上限は$P_{\mathrm{peak}}$で決まります。
つまり, 計測結果の良し悪しは理論FLOPSと比べるのではなく, Rooflineが与える上限$\min(P_{\mathrm{peak}}, I \cdot B)$と比べるべきです。Memory Boundなプログラムの達成FLOPSが理論FLOPSの5%しかなくても, $I \cdot B$に近ければそれはハードウェアの性能を引き出せていると言えます。
GH200のRidge Point
冒頭のスペック表からRidge Pointを計算してみます。
| 演算器 | $P_{\mathrm{peak}}$ | $B$ | $I^{*}$ [FLOP/Byte] |
|---|---|---|---|
| CPU (Grace, FP32) | 7.1 TFLOPS | 512 GB/s | 13.9 |
| GPU (CUDA Core, FP32) | 67 TFLOPS | 4.0 TB/s | 16.75 |
| GPU (Tensor Core, TF32) | 494 TFLOPS | 4.0 TB/s | 123.5 |
Tensor Coreを使う場合, Compute Boundになるには1 Byte読み込むごとに123.5回, FP32の値1つ(4 Byte)あたりに換算すると約500回もの演算が必要です。演算器の速さに対してメモリが相対的にとても遅いことがわかります。 このことから, GPUが世代を変わるごとにHBMの帯域幅を重視していることがわかると思います。また, 1つの値を読み込んで100回以上も同じ値を使い回すような演算というのは行列積のようなアルゴリズムがほとんどを占めているため, ほとんどのアルゴリズムはMemory boundであることがわかるでしょう。
行列積の演算強度
では行列積$C = AB$の演算強度を求めます。$C$の各要素は長さ$N$の内積で, 積と和がそれぞれ$N$回なので
\[W = 2N^3\]です。一方でデータ転送量$Q$は$W$と違って実装とキャッシュの大きさに依存するので, 一意には決まりません。そこでハードウェアの性能を評価するときは, どんな実装でもこれより少なくはできない転送量の下限$Q_{\min}$ を考えます。$Q \geq Q_{\min}$なので演算強度には上限$I \leq I_{\max} = W / Q_{\min}$があり, Rooflineの上限も$P \leq \min(P_{\mathrm{peak}}, I_{\max} \cdot B)$と書けます。
最も素朴な下限は, $A, B$をそれぞれ少なくとも1回は読み込み, $C$を少なくとも1回は書き込まなければならないというものです (compulsory traffic)。FP32 (4 Byte) なので
\[Q_{\min} \geq 3 \times 4N^2 = 12N^2 \quad [\mathrm{Byte}]\]となり, これだけを使うと
\[I_{\max} = \frac{2N^3}{12N^2} = \frac{N}{6}\]です。これだけを見ると, 行列積は$N$を大きくすればいくらでも演算強度が上がるように見えます。
Red-Blue Pebble Gameによる下限
しかし$12N^2$という下限は, 3つの行列が全てキャッシュに収まる場合にしか達成できません。キャッシュに収まらない場合, 一度キャッシュから追い出したデータをもう一度DRAMから読み直す必要が出てきます。この「容量$M$の高速なメモリと無限の低速なメモリの間で, 最低どれだけ転送が必要か」を定式化したのが, Hong と Kung によるRed-Blue Pebble Game [3] です。赤い石が高速メモリ(キャッシュ)にあるデータ, 青い石が低速メモリ(DRAM)にあるデータを表し, 赤い石は同時に$M$個までしか置けないというルールの下で, 計算グラフ全体を計算し終えるまでに必要な赤↔青の入れ替え回数の最小値を考えます。
Hong と Kungは, 通常の$O(N^3)$の行列積(Strassenなどは除く)の転送量が$\Omega(N^3 / \sqrt{M})$になることを示しました。その後Smithら [4] によって定数まで含めたタイトな下限が示されていて, 高速メモリに$S$ワード置けるとき転送量は漸近的に$2N^3 / \sqrt{S}$ワード以上になります。$M$ [Byte] $= 4S$ としてByteに直すと
\[Q_{\min} \gtrsim \max\left(12N^2, \frac{16N^3}{\sqrt{M}}\right) \quad [\mathrm{Byte}]\]となり, 演算強度の上限は
\[I_{\max} \lesssim \min\left(\frac{N}{6}, \frac{\sqrt{M}}{8}\right) \quad [\mathrm{FLOP/Byte}]\]になります。つまり行列積の演算強度は$N$とともに際限なく増えるのではなく, キャッシュサイズ$\sqrt{M}$で頭打ちになるというのが正しい結論です。$N/6$は「3つの行列がキャッシュに乗る」という条件付きの値に過ぎません。tilingなどの最適化は, 実際の$Q$をこの下限に近づけるための工夫です。
GH200で見積もってみると, GPU側 (H100) のL2キャッシュは50 MBなので$\sqrt{M}/8 \approx 880$ FLOP/Byte, CPU側 (Grace) のL3キャッシュは117 MBなので$\sqrt{M}/8 \approx 1350$ FLOP/Byteです。どちらもRidge Point (最大でも123.5) を十分上回るので, GH200ではDRAMとの間の転送に関してはキャッシュを上手く使えば大きな行列積をCompute Boundにできます。ただし同じ議論は「L2 ↔ Shared Memory」「Shared Memory ↔ レジスタ」の各階層にも当てはまり, 容量の小さい階層ほど$\sqrt{M}$が小さくなるので, 階層ごとのバンド幅も律速要因になりえます。
さて, $N$が小さく3つの行列が全てキャッシュに収まる範囲では$I_{\max} = N/6$がそのまま使えます。Ridge Pointを超える行列サイズ$N^{*} = 6I^{*}$を計算すると
| 演算器 | $I^{*}$ | $N^{*} = 6I^{*}$ |
|---|---|---|
| CPU (Grace, FP32) | 13.9 | 83 |
| GPU (CUDA Core, FP32) | 16.75 | 101 |
| GPU (Tensor Core, TF32) | 123.5 | 741 |
となります。
$N = 512$の結果をRooflineで見直す
$N = 512$のとき3つの行列の合計は3.1 MBで, GPUのL2キャッシュ (50 MB) にもGraceのL3キャッシュ (117 MB) にも十分収まるので$I_{\max} = 512 / 6 \approx 85.3$ FLOP/Byteです。Rooflineの上限を計算すると
- CPU: $\min(7.1\,\mathrm{T}, 85.3 \times 512\,\mathrm{G}) = 7.1$ TFLOPS (Compute Bound)
- GPU (Non Tensor Core): $\min(67\,\mathrm{T}, 85.3 \times 4.0\,\mathrm{T}) = 67$ TFLOPS (Compute Bound)
- GPU (Tensor Core): $\min(494\,\mathrm{T}, 85.3 \times 4.0\,\mathrm{T}) = 341$ TFLOPS (Memory Bound)
となり, Rooflineの上限に対する達成率は以下のようになります。ここまで自信ありげに解説してきたのですが, 意外とNumpyと普通のPyTorchのFP32 kernelが23~24%の性能しかでていないことがわかりました。これはブログを書くために今回初めて実験したのでちょっと驚きです。
| 手法 | GFLOPS | Rooflineの上限 (GFLOPS) | 達成率 |
|---|---|---|---|
| CPU (Numpy) | 1704 | 7100 | 24% |
| GPU (Non Tensor Core) | 15576 | 67000 | 23% |
| GPU (Tensor Core) | 20584 | 341000 | 6.0% |
ただ, $N = 512$は$N^{*} = 741$より小さいので, Tensor Coreの場合はMemory Boundとなり上限が理論FLOPSの約7割 (341 TFLOPS) に下がりますが, それでも達成率は6%程度です。CPU (Numpy) とGPU (Non Tensor Core) もCompute Boundの上限に対して2割台にとどまっています。Rooflineで考えてもまだ説明がつかないわけです。
小さい行列積でTensor Coreの性能が出ないことは研究でも問題として取り上げられています。SC25で発表されたKAMI [5] は, 大きなGEMMはすでにGPUのピーク性能近くに達している一方で, 小さな行列積やbatched GEMMにはまだ大きな最適化の余地があることを指摘しています。小さな行列では1つのthread block内でのデータのやり取り, すなわちレジスタとShared Memoryの間の通信が性能を律速します。KAMIはこれに対し, 分散メモリ向けに発展してきたcommunication-avoiding (CA) な行列積アルゴリズム(1D/2D/3D)を1つのGPUの中に持ち込みました。Tensor Coreを計算ノード, レジスタをローカルメモリ, Shared Memoryを通信路とみなして, 先ほどの転送量下限の議論を各メモリ階層に適用する発想です。先ほど述べた「階層ごとにRed-Blue Pebble Gameの下限が効く」ことの具体例とも言えます。
Rooflineに載らないもの: 固定コスト
もう1つ, Rooflineには載らない要因として問題サイズによらずかかる固定コストがあります。GPUであればカーネル起動(1~2μs程度)やPyTorchのディスパッチ, 同期, CPUであればライブラリ呼び出しやスレッドの起動・同期 (fork/join) などです。ここではオーダーだけ見積もってみます。
$N = 512$で, 演算時間$W / P_{\mathrm{peak}}$とデータ転送時間$Q_{\min} / B$を計測値と並べると以下のようになります。
| 手法 | 演算時間 | 転送時間 | 計測値 | 差 ($T_0$) |
|---|---|---|---|---|
| CPU (Numpy) | 38 µs | 6.1 µs | 158 µs | 約120 µs |
| GPU (Non Tensor Core) | 4.0 µs | 0.79 µs | 17.2 µs | 約13 µs |
| GPU (Tensor Core) | 0.54 µs | 0.79 µs | 13.0 µs | 約12 µs |
GPUでは演算と転送にかかる時間は数µsかそれ以下なのに, 実行時間は10 µs以上かかっています。しかもFP32とTensor Coreで差$T_0$がどちらも約12〜13 µsとほぼ同じで, 演算器によらない一定のコストが乗っていることがわかります。CPUも同様に, 100 µsのオーダーの固定コストが乗っていそうです。
そこで固定コスト$T_0$を加えた簡単なモデル
\[T \approx T_0 + \max\left(\frac{W}{P_{\mathrm{peak}}}, \frac{Q}{B}\right)\]を考えます。Compute Boundな領域で理論FLOPSに対して80%の効率を得るには$W / P_{\mathrm{peak}} \geq 4T_0$, すなわち
\[2N^3 \geq 4 T_0 P_{\mathrm{peak}} \quad \Longrightarrow \quad N \geq \left(2 T_0 P_{\mathrm{peak}}\right)^{1/3}\]が必要です。上の$T_0$を代入すると, CPU (Numpy) で$N \approx 1200$, GPU (Non Tensor Core) で$N \approx 1200$, GPU (Tensor Core) で$N \approx 2300$となります。理論FLOPSが高いほど固定コストの間にこなせたはずの演算量が多くなるので, 固定コストを隠すにはより大きな問題が必要になるわけです。$T_0$は実際には一定ではないのであくまでオーダーの見積もりですが, 「$N = 512$は理論FLOPSと比べるにはまだ小さい」ことはわかります。
行列サイズを変えて達成FLOPSを見る
次に, 実際に$N$を変えて計測した結果を見てみましょう。横軸は行列サイズ$N$, 縦軸は達成FLOPS, 点線は理論FLOPSです。Rooflineのような図ができることがわかるかと思います。実験中, 私が使っているClaude Codeが勝手にCPUの行列積の最適化も始めたため, その結果も追加してあります。CPU (NEON+OpenMP, 72 threads)がそうです。
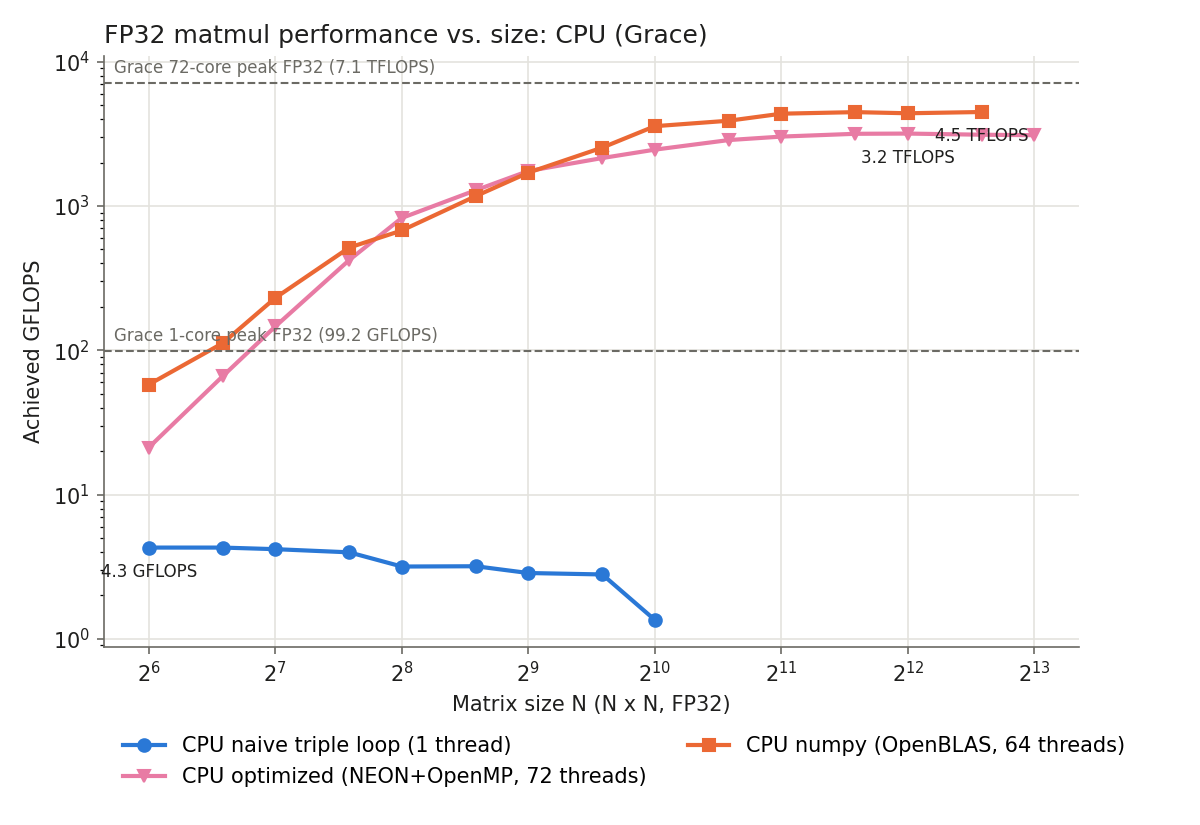
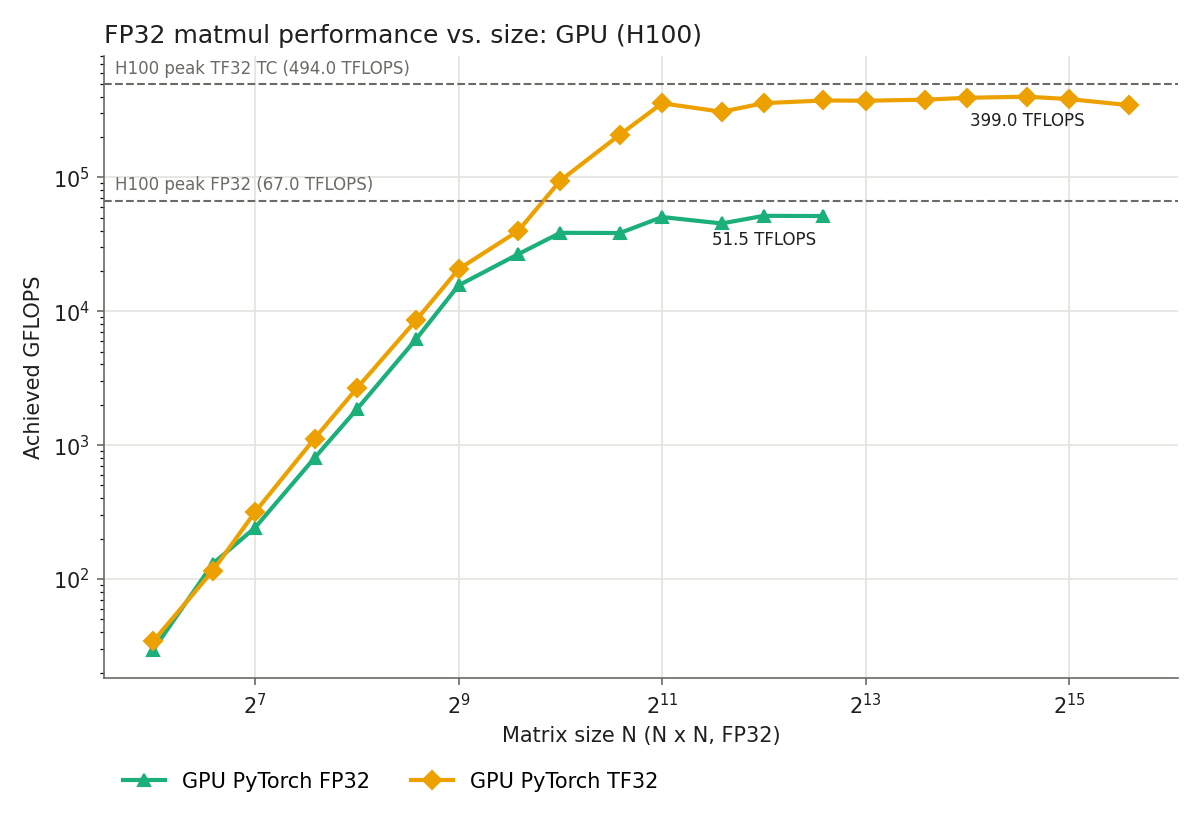
どの実装も$N$が大きくなるにつれて性能が上がり, やがて飽和します。飽和した値を理論FLOPSと比べると以下の通りです。
| 手法 | 最大達成FLOPS | 理論FLOPS | 達成率 |
|---|---|---|---|
| CPU (Naive, 1 thread) | 4.3 GFLOPS | 99.2 GFLOPS (1 core) | 4.3% |
| CPU (NEON+OpenMP, 72 threads) | 3.2 TFLOPS | 7.1 TFLOPS | 45% |
| CPU (Numpy, OpenBLAS 64 threads) | 4.5 TFLOPS | 7.1 TFLOPS | 63% |
| GPU (PyTorch FP32) | 51.5 TFLOPS | 67 TFLOPS | 77% |
| GPU (PyTorch TF32) | 399 TFLOPS | 494 TFLOPS | 81% |
ここからいくつかのことが読み取れます。
GPUは理論FLOPSの約8割に達している。 GPUの性能はTF32で$N = 2^{11}$付近, FP32で$N = 2^{10} \sim 2^{11}$付近で飽和しており, 先ほどの固定コストの見積もり (それぞれ約2300, 約1200) とオーダーが合っています。また十分大きな$N$での演算強度は$N/6 \gg I^{*}$なのでCompute Boundで, 上限は理論FLOPSです。cuBLASのような高度に最適化されたライブラリでも理論FLOPSの100%に到達することはほぼなく, 70〜90%程度が実用上の上限と考えてよいでしょう。
Naiveな実装は大きな$N$で性能がさらに落ちる。 Naive実装は1コアの理論FLOPS 99.2 GFLOPSに対しても4%程度しか出ておらず, $N = 2^{10}$では1.4 GFLOPSまで落ちます。最内ループのB[k * n + j]は$B$を列方向に$4N$ Byteの間隔で飛び飛びに読むため, 行列がキャッシュに収まらなくなると1要素(4 Byte)を使うためにキャッシュライン(64 Byte)全体をメモリから読むことになります。このとき実際の$Q$は下限$Q_{\min}$よりはるかに大きく, 実際の演算強度は$N/6$どころか1 FLOP/Byteを大きく下回ります。Naive実装はRooflineの斜めの線に張り付いた, 典型的なMemory Boundのプログラムなのです。
まとめ
計測結果がハードウェアの性能を引き出しているかを判断するには, 以下の手順で考えるとよいでしょう。
- 計算の演算量$W$とデータ転送量の下限$Q_{\min}$から演算強度の上限$I_{\max} = W / Q_{\min}$を求める。キャッシュに収まらない場合はRed-Blue Pebble Gameによる下限も考慮する。
- カタログスペックから$I^{*} = P_{\mathrm{peak}} / B$を求め, Memory BoundかCompute Boundかを判定する。
- 計測値を理論FLOPSではなくRooflineの上限$\min(P_{\mathrm{peak}}, I_{\max} \cdot B)$と比較する。
- 上限から大きく離れている場合は, 実装を確認し, 改善を行う(もちろん, 別の要因によりこれ以上の改善が不可能なこともあります。)
普段呼び出している関数1つが理論的な性能を引き出せているのかを考察する助けになれば幸いです。
この記事を読んだ皆様は何故メモリ帯域幅が必要なのか, ピーク性能の正確な見積もりはどうするかなどを答えることができるようになっていることでしょう!
Reference
[1] S. Williams, A. Waterman, D. Patterson, “Roofline: An Insightful Visual Performance Model for Multicore Architectures”, Communications of the ACM, 2009, https://doi.org/10.1145/1498765.1498785
[2] NERSC Documentation, Roofline Performance Model, https://docs.nersc.gov/tools/performance/roofline/
[3] J.-W. Hong, H. T. Kung, “I/O Complexity: The Red-Blue Pebble Game”, STOC, 1981, https://doi.org/10.1145/800076.802486
[4] T. M. Smith, B. Lowery, J. Langou, R. A. van de Geijn, “A Tight I/O Lower Bound for Matrix Multiplication”, arXiv:1702.02017, 2017, https://arxiv.org/abs/1702.02017
[5] H. Wang, Y. Du, S. Li, X. Tian, Q. Sun, W. Liu, “KAMI: Communication-Avoiding General Matrix Multiplication within a Single GPU”, SC ‘25, https://sc25.conference-program.com/presentation/?id=pap926&sess=sess285