モデリングと見積もり-1
これはHigh Performance Computingのシリーズ連載の一部です。
このブログで話すこと
前回の記事では単一の計算関数, GPUカーネルにおいて理論性能を見る方法を紹介しました。しかし実際にはシステム全体の最適化をするような人が多いかと思います。そこで今回はシステム全体の性能の上限を見積もる方法を紹介します。この記事を読むことで高速計算における性能の上限を見積もることができるようになり, 分析の手助けや必要ハードウェアの見積もりに使うことができます。
ハードウェアのスペック
| 項目 | 値 |
|---|---|
| Machine | NVIDIA GH200 |
| CPU FP32 FLOPS | 7.1 TFLOPS(計算値) |
| CUDA FP32 FLOPS | 67 TFLOPS |
| Tensor Core TF32 FLOPS | 494 TFLOPS |
| Tensor Core BF16 FLOPS | 989 TFLOPS |
| CPU Memory Bandwidth | Up to 512GB/s |
| GPU Memory Bandwidth | 4.0 TB/s |
| CPU-GPU間 (NVLink-C2C) | 900 GB/s (片方向450 GB/s) |
何故見積もりが重要か
この話は本来前回の記事ですべきだった気もしますが, 主に2つほど理由があると思います。
1. 最大性能を見積もるため
1つ目の理由は高速化という話をするなら誰でもこの理由が真っ先に思い浮かぶ気がしますが, 最大性能を見積もるためです。前回の記事では単一の計算関数, GPUカーネルにおいて理論性能を見る方法を紹介しました。何故これをする必要があるかというと, 最大性能のうち何%を出せたのかを言えないと正当な説明ができないためです。前回はCPUとGPUで計測した速度を比較しましたが, 何TFLOPS出たのか, それは理論値の何%なのかを知らないともしかしたらこれ以上高速化が可能かもしれないという懸念が残ってしまいます。ただし, 注意して欲しいのは見積もった最大性能が常に出るとは限らないことです。モデルの何かしらの見積もり漏れだったり, どうやってもアルゴリズム的に改善が難しい, CPUとGPUの間で消せないオーバーヘッドがあるなどで最大性能がでないこともあります。
2. 計測ミスを防ぐため
これは非常に重要なことです。計測をしていると計測中思わぬ出来事が起き, 「理論数値以上の速度」がでます。もしこれが起きたらあなたの測定が間違っている可能性が99.9999999%あります。例えば私は昔-O3オプションをつけて測定した1e9要素を持つ配列走査が1e-9秒のオーダーで終わりましたが, これはCPUの数クロック分の時間で10億要素の走査が終わったことになり, 現存するハードウェアではありえない速度です。このような結果を見た時にまず考えるべきことはなんでしょうか?もちろん見積もりです。1e9要素のintなら4GBでしょう。それを512GB/sのメモリから読み出したら最高効率でも8msはかかるはずです。この見積もりから明らかにおかしいことはわかりますよね????この時はコンパイラによるデッドコード削除最適化が起こっており, このような結果となりました。アセンブリを確認することでも確かめられたミスです。このように, 見積もりは非常に大切です‼
はじめに断っておくこと
ここから先で紹介する見積もり方は, 教科書的に体系立てられたものというより, 私が実際に実験と最適化を繰り返す中で「これをやっておくと助かる」と経験的に感じてきたものです。なので厳密な理論というよりは実践的な手順だと思って読んでください。また, ここで出てくる数値はあくまで上限の見積もりです。実際のハードウェアではクロックの変動, キャッシュの挙動, カーネル起動のオーバーヘッドなど様々な要因で理論値には届きません。大事なのは「理論値にどのくらい近いか」と「理論値を超えていないか」を常に意識することです。
方法1: カーネルの実行時間を積み上げて厳密に見積もる
1つ目は, 処理を構成するカーネル1つ1つについて理論時間を計算し, それを足し合わせることでシステム全体の時間を見積もる方法です。この記事全体ではLLM servingのdecode(1トークンずつ生成するフェーズ)を例にします。LLM Servingに限らずですが計測対象でどういった計算が走っているかをできるだけ厳密に把握し, その積み重ねで全体の時間が決まっていると考える基本的なモデリングがシステム全体の最適化には必要です。
1カーネルあたりのモデル
前回の記事と同じ考え方で, カーネル $k$ の計算量を $F_k$ [FLOP], メモリ転送量を $B_k$ [byte], ピーク演算性能を $P$, メモリ帯域を $W$ とすると, カーネルの実行時間は
\[t_k \ge \max\left(\frac{F_k}{P}, \frac{B_k}{W}\right)\]で下から抑えられます。そしてdecode 1 stepの時間は
\[T_{\text{step}} \ge \sum_k \max\left(\frac{F_k}{P}, \frac{B_k}{W}\right)\]となります。
Qwen3-30B-A3Bのdecodeを見積もる
具体例として, MoE modelであるQwen3-30B-A3B-Thinking(hidden 2048, 48 layers, Q 32 heads / KV 4 heads, head_dim 128, expert数128のうち1 tokenあたり8個を使用, expertのintermediate 768, vocab 151936)をBF16, batch size 1, context長4096でdecodeする場合を考えます。batch size 1のdecodeでは行列積は行列ベクトル積になり, 計算量は重み1要素(2 byte)あたり2 FLOPしかありません。算術強度は約1 FLOP/byteで, GH200のridge point($989\,\text{TFLOPS} / 4.0\,\text{TB/s} \approx 247$ FLOP/byte)よりはるかに小さいため, 完全にmemory boundです。したがって $B_k / W$ だけ見れば十分です。
また, MoEなのでbatch size 1では128個のexpertのうちrouterが選んだ8個の重みしか読みません。1 layerあたりの主要なカーネルは以下のようになります。
| カーネル | 読む量 | 理論時間 (4.0 TB/s) |
|---|---|---|
| QKV projection ($2048 \times 5120$) | 21.0 MB | 5.2 µs |
| Attention (KV cache 4096 tokens分) | 8.4 MB | 2.1 µs |
| O projection ($4096 \times 2048$) | 16.8 MB | 4.2 µs |
| Router ($2048 \times 128$) | 0.5 MB | 0.1 µs |
| Expert Gate/Up projection ($2048 \times 1536$ を8 expert分) | 50.3 MB | 12.6 µs |
| Expert Down projection ($768 \times 2048$ を8 expert分) | 25.2 MB | 6.3 µs |
| RMSNorm, QK norm, RoPE, top-k, SiLU×Mul, residual add など | 数十KB | カーネル起動などにかかる小さな時間$t_{\min}$ で律速 |
| 合計 | 122.2 MB | 30.5 µs + 小カーネル |
これを48 layer分積み上げ, 最後のLM head($2048 \times 151936$, 622 MB, 156 µs)を足すと
\[T_{\text{step}} \ge 48 \times 30.5\,\mu\text{s} + 156\,\mu\text{s} \approx 1.62\,\text{ms}\]となり, batch size 1では約617 tokens/sが上限ということがわかります。ただしMoEはrouterのtop-kやexpertごとのtokenの振り分けなど小さなカーネルが多くなりがちです。小カーネルが1 layerあたり8個あり, 仮にそれぞれ3 µsかかるとすると, $48 \times 8 \times 3\,\mu\text{s} \approx 1.15\,\text{ms}$ と, 重みを読む時間に匹敵するほど上乗せされます。これがkernel fusionやCUDA Graphが効く理由でもあります。
Nsight Systemsで答え合わせをする
見積もりを作ったら, 実際にどのカーネルが何µsかかっているのかをNsight Systemsで確認します。
# 実行例
nsys profile -t cuda,nvtx --cuda-graph-trace=node -o decode python bench_decode.py
nsys stats --report cuda_gpu_kern_sum decode.nsys-rep
以下はnsysで測定した結果をNsight SystemsのGUIで開いた時の例です。上部のタイムラインでどのstreamでいつどのカーネルが走っているかを, 下部のEvents Viewで各カーネルの実行時間を確認できます。
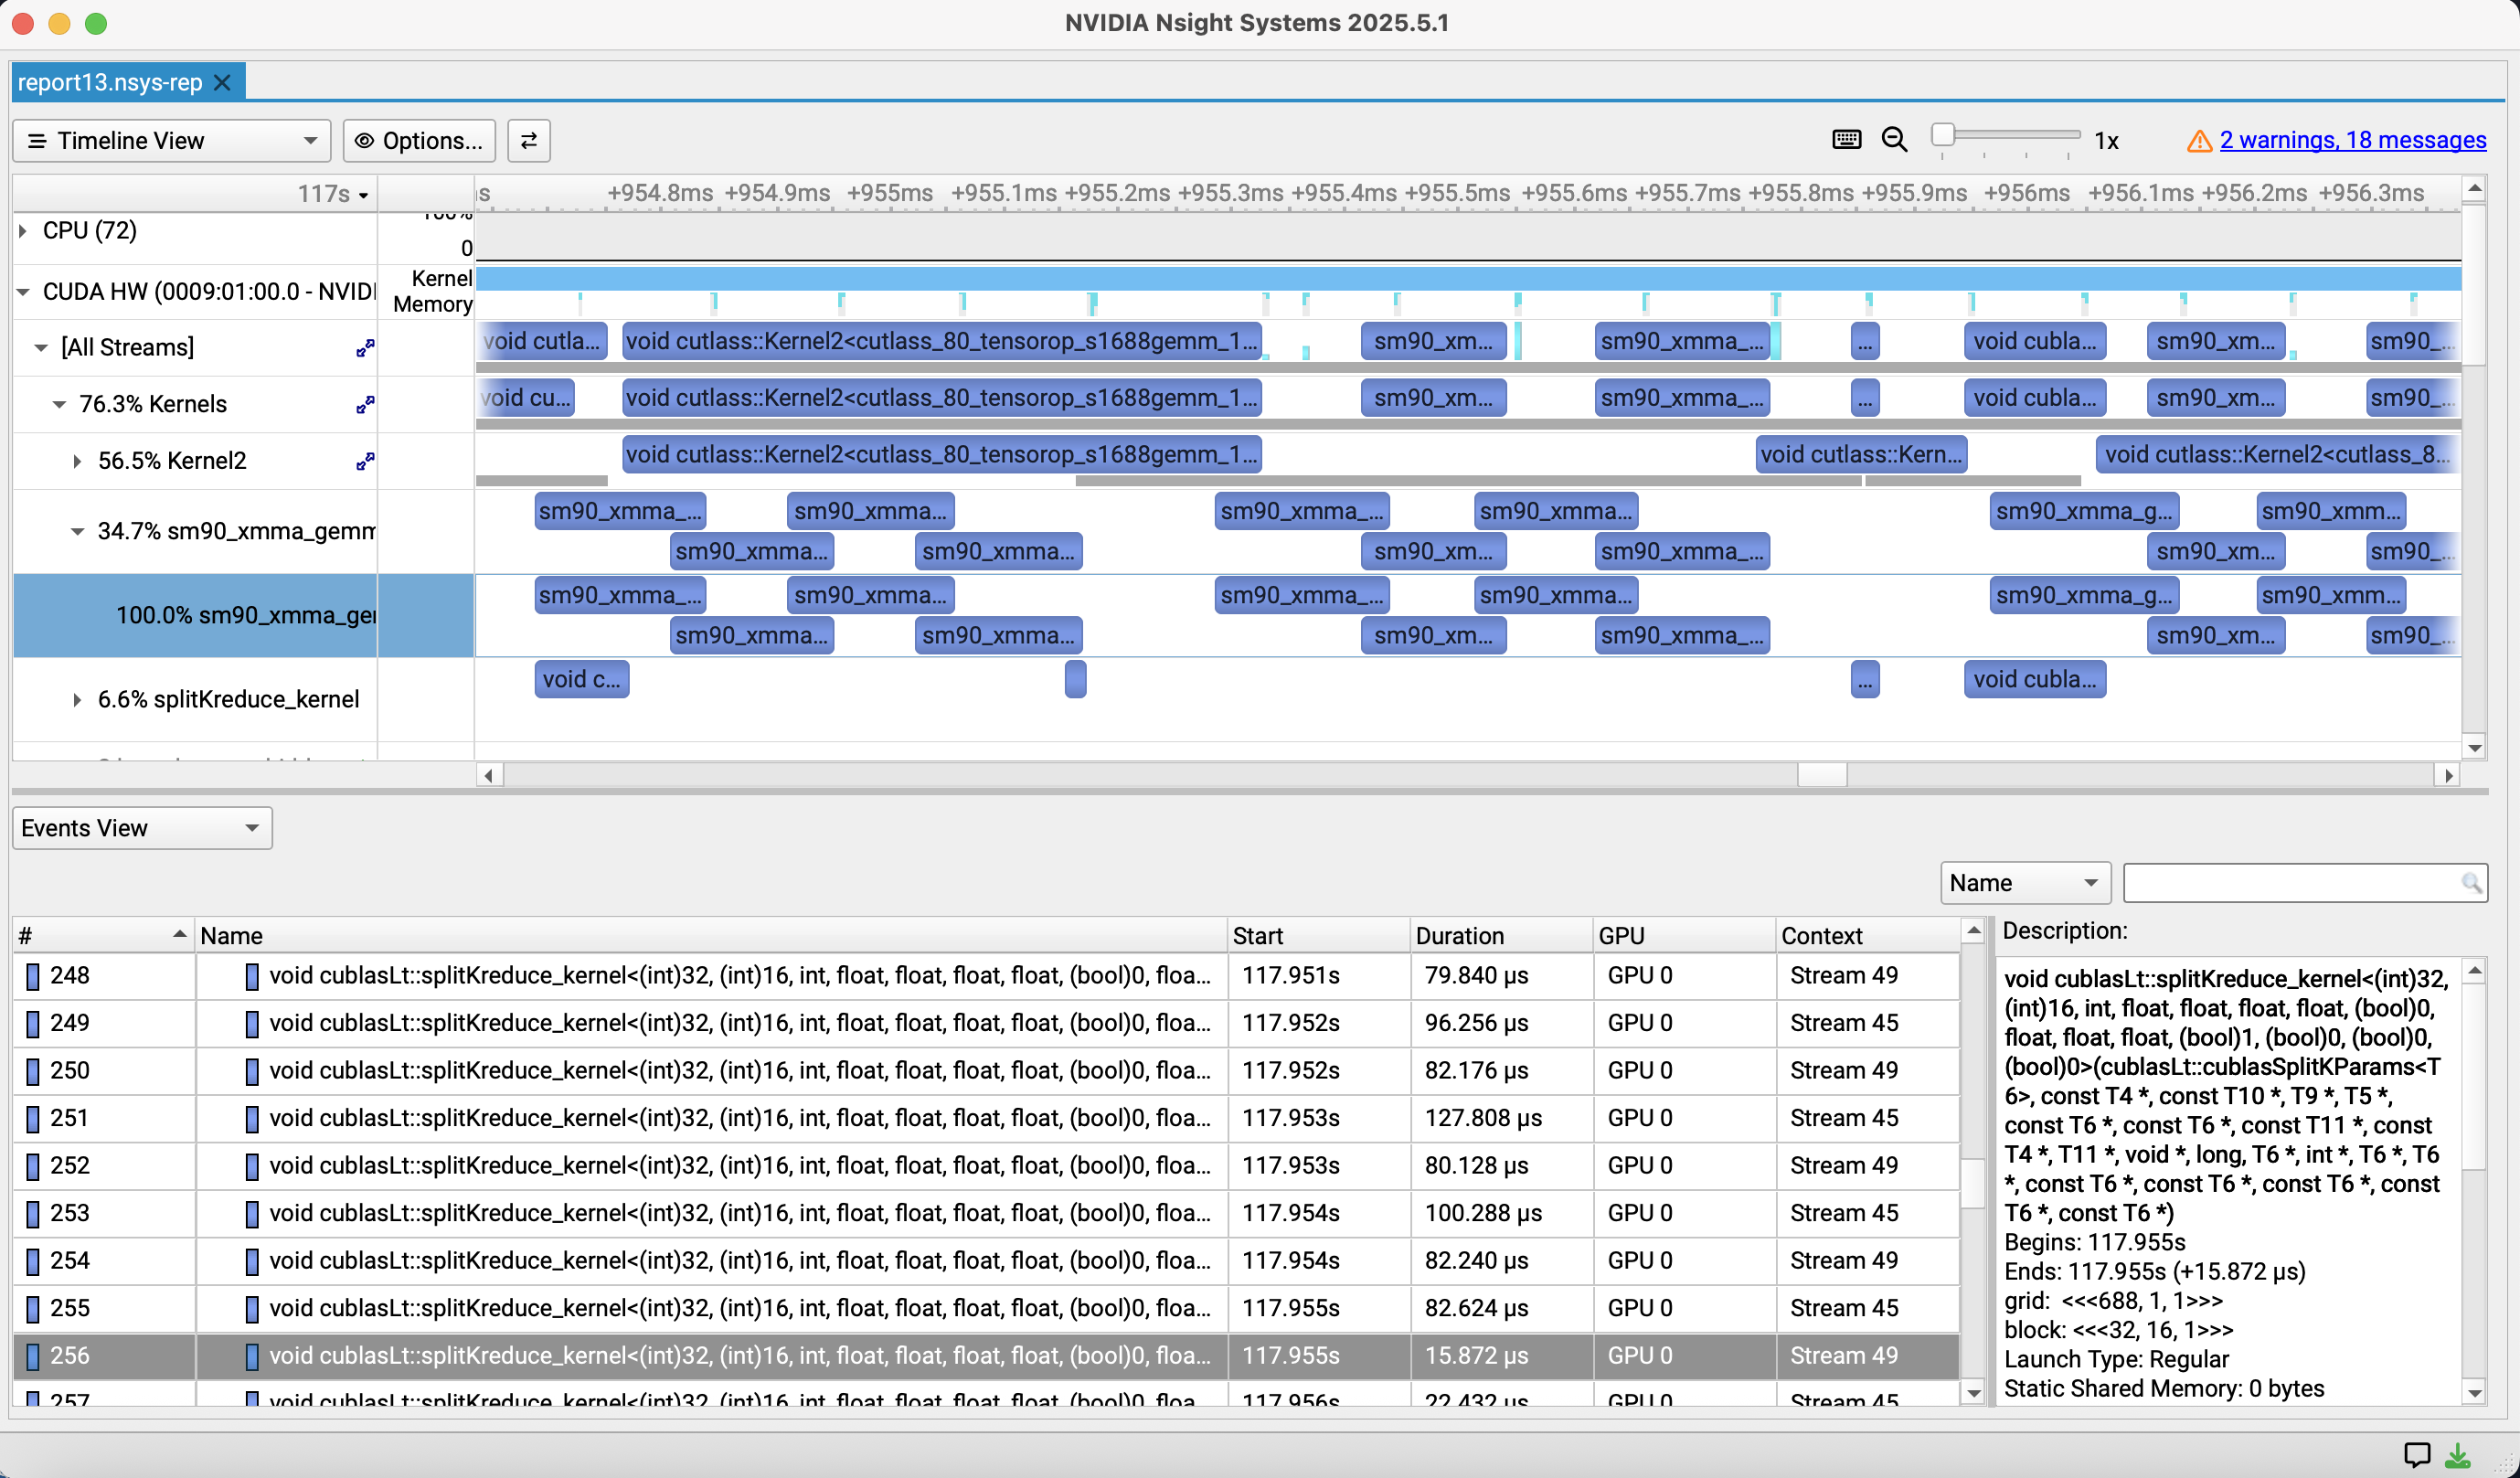
CUDA Graphを使っているservingエンジンでは, --cuda-graph-trace=node をつけないとグラフ全体が1つにまとめられてしまい, カーネルごとの時間が見えないので注意してください。カーネルごとの実測時間が取れたら, 上の表の理論時間と並べて「実測 / 理論」の比を見ます。比が極端に悪いカーネルや, 表に載っていないのに時間を食っているカーネルが最適化の対象になります。逆にstep全体の時間がカーネル時間の合計より大きく離れていれば, CPU側のスケジューリングやカーネル起動の隙間(GPUのアイドル)が問題だとわかります。CUDAGraphなどを使っていない推論ではこの手のオーバーヘッドがよくかかります。
この方法は手間がかかりますが, どこにどれだけ伸びしろがあるのかをカーネル単位で言えるのが強みです。
方法2: 「重みは最低1回はloadされる」から大雑把に見積もる
方法1は正確ですが, 新しいモデルやハードウェアを検討する段階でいちいちカーネルを列挙するのは大変です。そこで使えるのが, decodeでは1 stepごとに全ての重みを最低1回はメモリから読まなければならないという観点からの大雑把な見積もりです。重みはL2キャッシュ(数十MB)には到底乗らないので, 毎step HBMから読み直すことになります。したがって
\[T_{\text{step}} \ge \frac{\text{重みのbyte数}}{W}\]が成り立ちます。ここでMoEの場合, batch size 1なら読むのはactiveな重みだけです。Qwen3-30B-A3Bのactive parameterは約3.3Bなので $6.6\,\text{GB} / 4.0\,\text{TB/s} \approx 1.65\,\text{ms}$ となり, 方法1の1.62 msとほぼ同じ値がたった1行の計算で出てきます。一方でbatch sizeが大きくなるとtokenごとに違うexpertが選ばれるため, 読むexpertの数は増えていき, 最終的には全parameter(約30.5B, 61 GB)を読む $61\,\text{GB} / 4.0\,\text{TB/s} \approx 15\,\text{ms}$ に近づいていきます。Prefillでも多くのtokenが全expertに振り分けられるため, 読む重みの量としてはこちらに近くなります。ただしprefillは1度に多くのtokenを処理するので算術強度が高く, 計算律速になりえます。
1T parameter級のDense modelは重い
この見積もりを1T parameterのDense modelに当てはめてみます。BF16なら重みだけで2 TBです。
- そもそもGH200のHBM(96 GB)には乗りません。重みを置くだけでも最低21台が必要です。
- 仮に1台で全ての重みを読めたとしても, $2\,\text{TB} / 4.0\,\text{TB/s} = 0.5\,\text{s}$ で, 1 tokenに0.5秒かかります。
- 21台でtensor parallelにして帯域を束ねて21倍になったとして大雑把に見積もっても $2\,\text{TB} / 84\,\text{TB/s} \approx 24\,\text{ms}$ で, 通信を無視しても40 tokens/s程度が上限です。
FP8にしても半分になるだけなので, 1T級のDense modelを手元で動かすのはかなり無理があるということが, カーネルの詳細を一切知らなくてもわかります。
一方, Kimi K2のようなMoE modelは総パラメータが1T級でも, 1 tokenあたりに使われる(active)パラメータは32B程度です。1 tokenで読む必要がある重みはactiveな分だけなので, 見積もりの分子が30分の1以下になります。これが巨大モデルでMoEが主流になっている理由の1つであり, 使わないexpertをCPUメモリに逃がしておく expert offload という手法が成り立つ理由でもあります。
実例: FreeTokenの改善
最後に, 実際に見積もりがコントリビュートに繋がった例として, 私がFreeTokenを改善した時の話をします。FreeTokenは巨大なモデルを手元のマシンで動かすためのServing Engineで, MoE modelの一部expertをCPUメモリにoffloadし, GPU上にはよく使われるexpertだけをLRUでcacheしておく仕組みを持っています。cacheにないexpertが必要になると(cache miss), CPUメモリからGPUへexpertの重みを転送します。Interconnectの帯域幅によっては一部をCPUで実行したりもします。
見積もりと実測のズレに気づく
GH200でFreeTokenを使って計測していた時, decode中のcache missの回数と, 1回のmissで転送されるexpertの重みのサイズ(例えばBF16のQwen3-30B-A3Bなら1 expertあたり $3 \times 2048 \times 768 \times 2\,\text{B} \approx 9.4\,\text{MB}$)を掛けて転送量を計算し, それを転送にかかっている時間で割ってみました。すると実効帯域は約220 GB/sにしかなっていませんでした。GH200のCPU-GPU間はNVLink-C2Cで片方向450 GB/s, copy engineで単純にH2Dコピーした場合でも約418 GB/s出ることが計測できていたので, expertの転送は理論帯域の半分程度しか使えていないことになります。
GH200, ft bench bw |
GB/s |
|---|---|
| NVLink-C2C 理論値 (H2D) | 450 |
| copy engineによる単純なH2Dコピー | 418 |
| expert gather (nvfp4 / bf16 / mxfp4) | 222 / 202 / 212 |
ここで「GPU-CPU間の転送ってこんなものか」で終わらせず, 理論値と並べて見たことで, 明らかに改善の余地があるとわかりました。
原因: in-flightなリクエストが足りない
expertの転送は fast_index_copy_multi というzero-copyのgather kernelで行われていました。各threadはmapされたhostメモリから16 byteをloadして書き込み, それが終わってから次のloadを発行します。このため同時に飛んでいる(in-flightな)データ量は1 bankあたり
程度になり, 帯域はLittle’s lawによって
\[\text{帯域} \approx \frac{\text{in-flightなbyte数}}{\text{往復レイテンシ}}\]で決まります。デフォルトの blocks_per_bank=8 (1 bankあたり8192 threads)はPCIe(約31 GB/s)の環境でチューニングされた値でした。PCIeは帯域が小さいので, この程度のin-flight量でもレイテンシを隠して帯域を使い切れます。しかしNVLink-C2Cは帯域がずっと大きいので, 同じレイテンシを隠すにはそれに比例してより多くのリクエストを同時に飛ばす必要があります。
修正と結果
そこでNVLink-C2Cを持つホスト(GH200 / GB200 / GB300)では blocks_per_bank を32にするよう変更しました(PR #610)。最初はデバイス名の判定でCUDAが初期化されてしまい, CUDAの初期化をengine側が管理するという前提を壊してしまったため環境変数での指定に切り替えたのですが, レビューでengineがGPUを確保した後(_build_fused_copy_planの中)でデバイスを判定すればよいと提案をもらい, 最終的には自動判定と環境変数 FREETOKEN_H2D_BLOCKS_PER_BANK による上書きの両方に対応する形でマージされました。
| expert gather (GH200) | blocks_per_bank=8 |
blocks_per_bank=32 |
|---|---|---|
| bf16 | 202 GB/s | 408 GB/s |
| nvfp4 | 222 GB/s | 410 GB/s |
| mxfp4 | 212 GB/s | 408 GB/s |
copy engineによるH2Dコピーの上限(約418 GB/s)にほぼ並ぶところまで改善できました。変更自体は数行ですが, そもそも「この数字は遅い」と気づけたのは, cache miss回数と転送量から実効帯域を計算し, 理論値と並べて見たからです。
まとめ
- 見積もりは, 自分の実装が上限の何%を出せているかを知るためと, 計測ミスに気づくための両方で重要です。
- カーネルごとに $\max(F_k/P, B_k/W)$ を積み上げると, どこに伸びしろがあるかまで言える精密な見積もりができ, Nsight Systemsで答え合わせができます。
- 「重みは最低1回loadされる」という1行の見積もりだけでも, 1T級のDense modelが重すぎることや, MoE + offloadが有効な理由がわかります。
- 実効帯域を計算して理論値と比べる習慣が, 実際にOSSへの性能改善に繋がりました。