HPCの法則とか細かいモデリングとか
これはHigh Performance Computingのシリーズ連載の一部です。
このブログで話すこと
前回の記事ではモデル全体の性能の上限を見積もる方法を, 前々回の記事では単一のカーネルの性能をカタログスペックと比べる方法を紹介しました。今回はその2回で紹介しきれなかった細かい話を2つ書きます。
- 並列化したときにどこまで速くなるかを表すアムダールの法則とグスタフソンの法則, そしてそれぞれに対応する強スケーリングと弱スケーリング
- これまでカタログスペックの値をそのまま使っていたピーク性能を, ハードウェアの構成から自分で計算する方法
ハードウェアのスペック
| 項目 | 値 |
|---|---|
| Machine | NVIDIA GH200 |
| CPU | NVIDIA Grace (Arm Neoverse V2, 72 cores) |
| GPU | NVIDIA H100 (132 SMs) |
| CPU FP32 FLOPS | 7.1 TFLOPS(計算値, 後述) |
| CUDA FP32 FLOPS | 67 TFLOPS |
| Tensor Core TF32 FLOPS | 494 TFLOPS |
| Tensor Core BF16 FLOPS | 989 TFLOPS |
アムダールの法則とグスタフソンの法則
GPUを1枚から8枚に増やしたら8倍速くなるでしょうか?多くの場合なりません。プログラムには並列化できない部分があるからです。この「並列化できない部分がどれだけ足を引っ張るか」を表すのがアムダールの法則とグスタフソンの法則です。この2つはよく対立するものとして紹介されますが, 実際には何を固定して速度向上を測るかが違うだけで, 別の問いに答えています [1] [2]。
アムダールの法則: 問題サイズを固定する
アムダールの法則 [3] は, 問題サイズ(全体の仕事量)を固定したまま, プロセッサ数 $N$ を増やしたときの速度向上を考えます。1プロセッサでの実行時間を1とし, そのうち並列化できる部分の割合を $p$, できない部分を $1 - p$ とします。$N$ プロセッサでは並列化できる部分だけが $1/N$ になるので, 実行時間は $(1-p) + p/N$ となり, 速度向上は
\[S_{\text{Amdahl}}(N) = \frac{1}{(1 - p) + \frac{p}{N}}\]です。$N \to \infty$ としても
\[S_{\text{Amdahl}}(\infty) = \frac{1}{1 - p}\]で頭打ちになります。
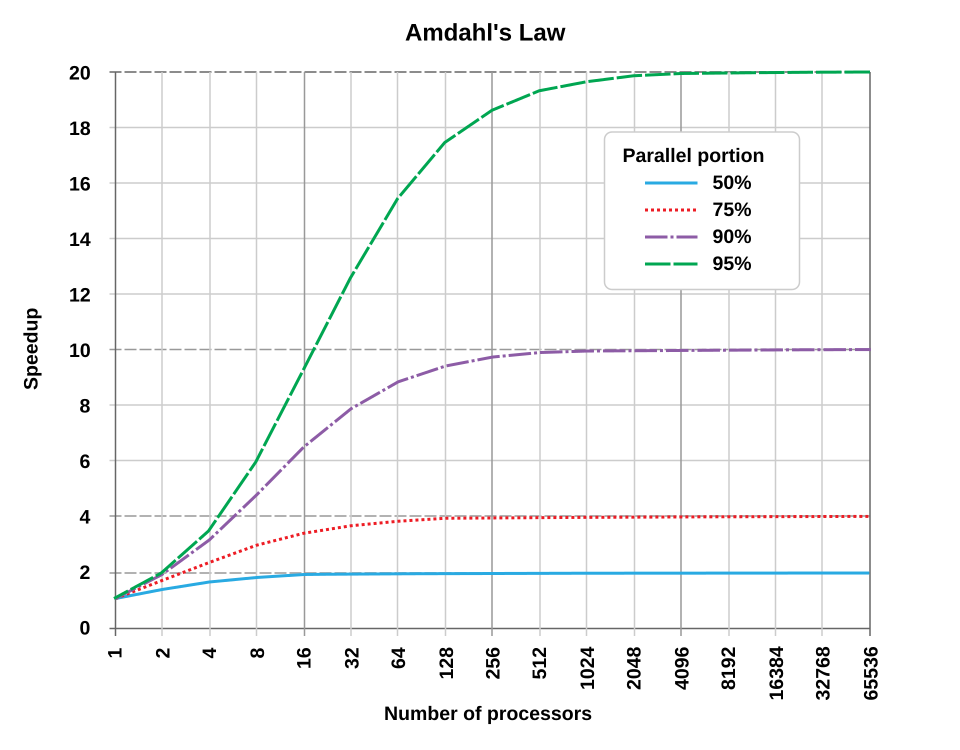 画像はWikimedia Commons [7]より取得 (Daniels220, CC BY-SA 3.0)
図は並列化可能な割合 $p$ ごとに, プロセッサ数と速度向上の関係を描いたものです。横軸が対数であることに注意してください。$p = 0.95$ (95%が並列化可能)でも, 速度向上は最大20倍です。$N = 8$ なら $1 / (0.05 + 0.95/8) \approx 5.9$ 倍で, 並列化効率 $S/N$ は74%です。仕事量が固定されているので, $N$ を増やすほど並列部分は縮んでいき, 縮まない逐次部分の割合が相対的に大きくなっていく, というのがこの法則の本質です。
グスタフソンの法則: 実行時間を固定する
一方でグスタフソンの法則 [4] は, 実行時間を固定して, プロセッサ数 $N$ が増えた分だけ問題サイズを大きくすることを考えます。実際, プロセッサが増えたら同じ問題を速く解くよりも, より大きな問題(より細かいメッシュ, より大きなモデル, より多くのリクエスト)を同じ時間で解きたいことの方が多いはずです。
今度は $N$ プロセッサでの実行時間を1とし, そのうち逐次部分の割合を $s$, 並列部分の割合を $1 - s$ とします。この並列部分の仕事を1プロセッサでやろうとすると $N$ 倍の時間がかかるので, 同じ仕事量を1プロセッサで処理した場合の時間は $s + (1 - s)N$ です。したがって速度向上は
\[S_{\text{Gustafson}}(N) = s + (1 - s)N = N - s(N - 1)\]となり, $N$ に比例して伸び続けます。$s = 0.05$, $N = 8$ なら $8 - 0.05 \times 7 = 7.65$ 倍です。
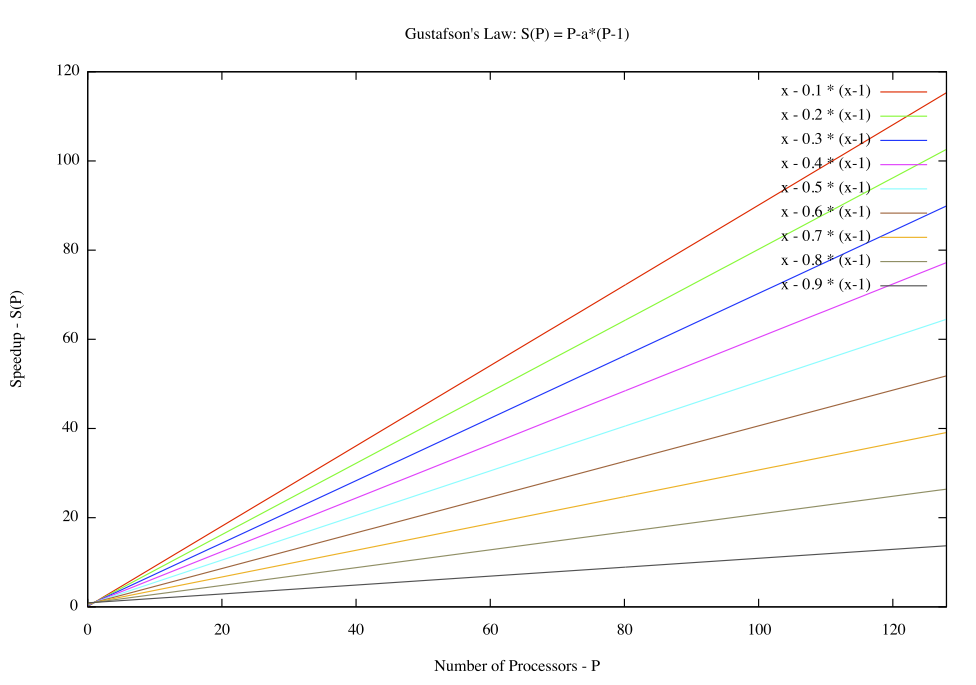 画像はWikimedia Commons [8]より取得 (Peahihawaii, CC BY-SA 3.0)
図の $a$ が逐次部分の割合 $s$ です。アムダールの法則の図と違って横軸は線形ですが, どの $s$ でも速度向上は直線的に伸びていき, 頭打ちになりません。
何が固定されているのか
2つの式の違いは, 逐次部分の割合をどこで測っているかにあります。
| 法則 | 固定するもの | 割合をどこで測るか | $N \to \infty$ での速度向上 |
|---|---|---|---|
| アムダール | 問題サイズ(全体の仕事量) | 1プロセッサでの実行時間に対する並列部分の割合 $p$ | $1/(1-p)$ で頭打ち |
| グスタフソン | 実行時間(= 1プロセッサあたりの仕事量) | $N$ プロセッサでの実行時間に対する逐次部分の割合 $s$ | $N$ に比例して伸びる |
グスタフソンの設定では問題サイズが $N$ に比例して大きくなるので, 1プロセッサで実行したと考えると逐次部分の割合はどんどん小さくなっていきます。アムダールの式に入れる $p$ が $N$ とともに1に近づいていくと言ってもよいです。どちらが正しいということではなく, 同じ問題を速く解きたいのか, 大きな問題を同じ時間で解きたいのかで使う式が変わります。
強スケーリングと弱スケーリング
この2つの法則に対応する計測の仕方が強スケーリング(strong scaling)と弱スケーリング(weak scaling)です。論文やベンチマークでスケーラビリティを主張しているときは, どちらの計測なのかを必ず確認してください。
強スケーリングは, 全体の問題サイズを固定してプロセッサ数を増やします。アムダールの法則の世界です。理想的には実行時間が $1/N$ になり, 並列化効率は
\[E_{\text{strong}}(N) = \frac{T(1)}{N \cdot T(N)}\]です。LLM servingで言えば, 同じbatchのdecodeを1枚のGPUからtensor parallelで8枚に分けて1 stepの時間を短くしたい, という状況です。前回の記事で1T parameterのDense modelを21台で動かしたら帯域が21倍になる, と見積もったのは理想的な強スケーリングを仮定していたことになります。
弱スケーリングは, 1プロセッサあたりの問題サイズを固定してプロセッサ数を増やします。グスタフソンの法則の世界です。理想的には実行時間が一定のままで, 並列化効率は
\[E_{\text{weak}}(N) = \frac{T(1)}{T(N)}\]です。ここで $T(N)$ は $N$ 倍の大きさの問題を $N$ プロセッサで解いた時間です。GPUあたりのbatch sizeを固定してdata parallelで学習する場合や, GPUごとに独立したレプリカを立ててリクエストを捌く場合がこれに当たります。
一般に弱スケーリングの方が良い数字が出やすく, 強スケーリングは難しいです。強スケーリングでは $N$ を増やすほど1プロセッサあたりの仕事が小さくなり, 前々回の記事で見たような固定コスト(カーネル起動など)や, 次に述べる通信の割合が大きくなるからです。
通信を入れたもう少し細かいモデル
アムダールの法則は逐次部分と並列部分の2つしか考えていませんが, 実際の並列プログラムでは通信のコストがかかり, しかもそれは $N$ とともに変化します。そこで実行時間を
\[T(N) = T_{\text{serial}} + \frac{T_{\text{parallel}}}{N} + T_{\text{comm}}(N)\]と書いてみます。例えばtensor parallelのdecodeでは, 各layerでall-reduceが必要になります。ring all-reduceならGPUあたりの転送量はデータサイズ $D$ に対して $2D(N-1)/N$ で, $N$ を増やしてもほとんど減りません。さらにall-reduceの段数に比例するレイテンシも乗ります。つまり $T_{\text{parallel}}/N$ は $N$ とともに減っていくのに $T_{\text{comm}}(N)$ は減らないか増えていくので, どこかで $T(N)$ は最小になり, それ以上GPUを増やすと逆に遅くなります。batch size 1のdecodeでは1 layerあたりの計算が数十µsしかないので, 数µs〜十数µsのall-reduceでもすぐに無視できなくなります。
このように, アムダールの法則で上限を押さえ, そこに通信や固定コストの項を足していくのが, 前回の記事で紹介したカーネル単位の積み上げと同じ発想のモデリングです。
ピーク性能を自分で計算する
これまでの記事では, 7.1 TFLOPSや494 TFLOPSといったピーク性能をカタログスペックの値として使ってきました。しかしこの値はどこから来ているのでしょうか?カタログの数字をそのまま信じるのではなく, ハードウェアの構成から計算できるようにしておくと, 以下のような場面で役に立ちます。
- カタログに載っていない精度(FP64, INT8など)や, 載っていない演算器の性能を知りたいとき
- 1コアや1 SMだけを使うプログラムの上限を知りたいとき(前々回の記事でNaive実装を1コアの理論FLOPS 99.2 GFLOPSと比べたのがこれです)
- 実際の動作周波数がカタログの値と違うとき
- そもそもCPUのピーク性能はカタログに載っていないことが多いとき(前回までの表の「計算値」はこれです)
以下の導出は, 東京大学の講義「並列分散プログラミング」の資料 [5] を参考にしています。
CPU
CPUのピーク性能は
\[\text{peak performance} = \text{SIMD width} \times \text{instructions/cycle/core} \times \text{freq} \times \text{cores}\]です。1命令で SIMD width 個の要素を処理する命令を, 1コアで1サイクルあたり何本発行できるか, それが1秒あたり何サイクルあり, コアが何個あるか, という掛け算です。FLOPSで考える場合, 最も演算量の多い命令は FMA (Fused Multiply Add), つまり $d = a \times b + c$ で, 1要素あたり乗算と加算の2 FLOPになります。したがって
\[\text{peak FLOPS} = (2 \times \text{SIMD width}) \times \text{FMA insts/cycle/core} \times \text{freq} \times \text{cores}\]です。
GH200のGraceはArm Neoverse V2コアで, 128 bitのSIMDパイプラインを4本持ち, それぞれが毎サイクルFMAを発行できます。FP32なら128 bitに4要素入るのでSIMD widthは4です。周波数はGH200のデータシート [6] に載っていて, Base frequency 3.1 GHz, all-core SIMD frequency 3.0 GHz です。Base frequencyの3.1 GHzを使うと
\[\begin{aligned} \text{1 core} &= (2 \times 4) \times 4 \times 3.1\,\text{G} = 99.2\,\text{GFLOPS} \\ \text{72 cores} &= 99.2\,\text{GFLOPS} \times 72 \approx 7.1\,\text{TFLOPS} \end{aligned}\]となり, これがこれまで使ってきた7.1 TFLOPSの正体です。ただし, 72コア全てでSIMD命令を回し続けたときの周波数は3.0 GHzとされているので, 行列積のように全コアでFMAを使い切る計算の上限としては
\[(2 \times 4) \times 4 \times 3.0\,\text{G} \times 72 \approx 6.9\,\text{TFLOPS}\]の方が正確です。とはいえ差は3%程度なので, これまでの記事の議論はそのまま成り立ちます。1コアだけを使うNaive実装の上限(99.2 GFLOPS)は3.1 GHzのままで構いません。FP64ならSIMD widthが2になるので, それぞれ半分の3.6 TFLOPS, 3.5 TFLOPSです。
この式からわかることもあります。SIMD命令を使わずにスカラーのFMAしか使わないコードは, 最大でも $1/4$ (FP32)しか性能が出ません。FMAを使わず乗算と加算を別々に発行するコードも最大で半分です。前々回の記事のNaive実装が1コアのピーク性能の4%程度しか出ていなかったのは, メモリの問題に加えてこういった要因も積み重なっています。
GPU (CUDA Core)
GPUでも考え方は同じです。GPUではSIMD命令の代わりに, 32 threadからなる warp が同じ命令を一斉に実行します。つまりwarp width (32) がSIMD widthに, SMがコアに相当します。(というか, GPUの実行方式であるSIMT (Single Instruction, Multiple Threads) は, SIMDの各レーンをスレッドとして書けるようにした発展形なので当たり前ではあります [10]。)
\[\text{peak FLOPS} = (2 \times \text{warp width}) \times \text{warps/cycle/SM} \times \text{freq} \times \text{SMs}\]H100のSMは4つのサブパーティションに分かれていて, それぞれが毎サイクル1 warp分(32 lane)のFP32 FMAを実行できます(SMあたりFP32コアが128個と言われるのはこれです)。したがって warps/cycle/SM = 4 で, 132 SMsです。
GPUの周波数は, CPUと違ってGH200のデータシート [6] には載っていませんが, GH200のGPUの最大ブーストクロックは1980 MHzです [9]。実際に手元のGH200で確認しても1980 MHzでした。
$ nvidia-smi --query-gpu=clocks.max.sm --format=csv
clocks.max.sm [MHz]
1980 MHz
これを使うと
\[(2 \times 32) \times 4 \times 1.98\,\text{G} \times 132 \approx 66.9\,\text{TFLOPS}\]となり, スペック表の67 TFLOPSが出てきます。
GPU (Tensor Core)
Tensor Coreは1命令で小さな行列積をまとめて計算する演算器です。H100のTensor Coreは, TF32の入力 $A$ ($4 \times 8$), $B$ ($8 \times 8$) とFP32の $C$ に対して $C = A \times B + C$ を毎サイクル1回計算できます [5]。$4 \times 8$ の出力の各要素について長さ8の内積(FMA 8回)を行うので, 1サイクルあたりの演算量は
\[2 \times 4 \times 8 \times 8 = 512\,\text{FLOP/cycle}\]です。H100の各SMにはTensor Coreが4つあるので, 132 SMsで $4 \times 132 = 528$ 個のTensor Coreがあり, 同じく1.98 GHzとすると
\[512\,[\text{FLOP/cycle}] \times 1.98\,\text{G}\,[\text{cycle/s}] \times 528\,[\text{Tensor Cores}] \approx 535.3\,\text{TFLOPS}\]となります。CUDA Coreの1 SMあたり256 FLOP/cycleに対してTensor Coreは $512 \times 4 = 2048$ FLOP/cycleと8倍で, これがTensor Coreを使うと速い理由です。
さらに精度を下げると, 1サイクルで処理できる要素数が精度に反比例して増えるので, FP16/BF16で1070.5 TFLOPS, FP8で2141.1 TFLOPS (いずれもdense)になります。ここで計算した値は全てdenseな行列積の値です。カタログには2:4 structured sparsityを使った値が並記されていることがあり, そちらはdenseの2倍になっているので注意してください。
式でかなり正確に予測できる
ここまでの計算結果をデータシート [6] の値と並べてみます。
| 演算器 | 式による計算値 (1.98 GHz) | データシート | データシート / 計算値 |
|---|---|---|---|
| CUDA Core FP32 | 66.9 TFLOPS | 67 TFLOPS | 1.00 |
| Tensor Core TF32 | 535.3 TFLOPS | 494 TFLOPS | 0.92 |
| Tensor Core BF16 | 1070.5 TFLOPS | 990 TFLOPS | 0.92 |
| Tensor Core FP8 | 2141.1 TFLOPS | 1,979 TFLOPS | 0.92 |
CUDA Coreは式の値がそのままデータシートの値になっています。Tensor Coreはデータシートの方が8%ほど低いですが, 注目してほしいのはその比がTF32, BF16, FP8で全て0.92で一定なことです。式の中で精度によって変わるのは1サイクルあたりの演算量だけなので, 比が一定ということは, ずれの原因はそこではなく全精度に共通する項, つまり周波数だということになります。NVIDIAは理由を明記していませんが, Tensor Coreをフルに使うような消費電力の大きい処理では最大ブーストクロックを維持できないことを見込んで, 低めの周波数でTensor Coreの性能を出していると考えられます。
このように, ピーク性能は SIMD width, 1サイクルあたりの命令数, 周波数, コア数という数個の要素の掛け算で, かなり高い精度で予測できます。そして, 予測とずれたときも, どの要素がずれているのかまで絞り込めます。
これが嬉しいのは, 計測した性能が理論FLOPSに届かないときに, どの要素が足りていないのかを分解して分析できるからです。カタログの494 TFLOPSという数字だけを持っていても「8割しか出ていない」以上のことは言えません。しかし式に分解しておけば
- 周波数: 計測中にクロックが下がっていないか
- SIMD width: SIMD命令やTensor Coreの命令が使われているか(スカラー命令やCUDA Coreに落ちていないか)
- 1サイクルあたりの命令数: FMAを使っているか, 毎サイクル命令を発行できているか
- コア数: 全てのコアやSMに仕事が割り振られているか
のように, 1つずつ確認できる仮説に分けて考えることができます。次の節では, この中でも特に見落としやすい周波数について説明します。
周波数は一定ではない
Tensor Coreのデータシートの値が最大ブーストクロックで計算した値より低かったのと同じく, CPU側でもGraceのデータシートはbase frequency (3.1 GHz) とは別にall-core SIMD frequency (3.0 GHz) を載せています。全コアでSIMD演算器を動かし続けると, 電力の制約で周波数が下がるからです。
GPUもCPUも, 消費電力や温度に応じて動作周波数を動的に変えます。データシートやスペック表に載っている周波数で実際に動いている保証はありません。
つまり, 理論ピーク性能の式の中で最も不確かなのは周波数です。実験の際は, 実際の周波数を確認しておくとよいでしょう。
# GPU: 現在のクロックと最大クロック
nvidia-smi --query-gpu=clocks.sm,clocks.max.sm --format=csv
# 計測中のクロックの推移を見る
nvidia-smi dmon -s pc
# CPU
lscpu | grep -i mhz
計測中のクロックが1.6 GHzに落ちていれば, Tensor Core TF32の上限は $512 \times 1.6\,\text{G} \times 528 \approx 433$ TFLOPSです。前々回の記事でPyTorch TF32の行列積が399 TFLOPS (494 TFLOPSの81%)出ていましたが, 実際の周波数で計算し直した上限と比べると, 達成率はもっと高いかもしれません。逆に, 周波数が落ちているのに気づかないと, 実装が悪いと勘違いして存在しない伸びしろを探し続けることになります。
カタログの494 TFLOPSという数字だけでは, この「周波数が下がっていたから」という分析はできません。式からピーク性能を見積もっておくと, 理論FLOPSが出ていないときに周波数のような要因まで踏み込んで分析できる, というのがスペック値だけで終わらせない一番の理由です。
まとめ
- アムダールの法則は問題サイズを固定したときの速度向上で, 逐次部分の割合 $1-p$ によって $1/(1-p)$ で頭打ちになります。これは強スケーリングに対応します。
- グスタフソンの法則は実行時間(1プロセッサあたりの仕事量)を固定したときの速度向上で, $N$ に比例して伸びます。これは弱スケーリングに対応します。
- 実際の並列化では通信や固定コストの項が $N$ とともに変わるので, それをモデルに足していくと, GPUを増やしても速くならなくなる点を見積もれます。
- ピーク性能は $(2 \times \text{SIMD width}) \times \text{FMA insts/cycle/core} \times \text{freq} \times \text{cores}$ で計算でき, GPUではwarp widthとSM数, Tensor Coreでは1サイクルあたりの行列積のサイズに置き換えるだけです。この式でデータシートの値をかなり正確に再現できます。
- 式に分解しておくと, 理論FLOPSが出ていないときに周波数, SIMD, FMA, コア数のどれが原因なのかを分析できます。
- 式の中で最も変わりやすいのは周波数です。H100のTensor Coreのデータシートの値が最大ブーストクロックより低い周波数で計算されていたり, GraceにSIMD用の周波数が別に定められていたりします。計測中の実際のクロックを確認し, それに基づいた上限と比べましょう。
Reference
[1] Wikipedia, “Amdahl’s law”, https://en.wikipedia.org/wiki/Amdahl%27s_law
[2] Wikipedia, “Gustafson’s law”, https://en.wikipedia.org/wiki/Gustafson%27s_law
[3] G. M. Amdahl, “Validity of the single processor approach to achieving large scale computing capabilities”, AFIPS Spring Joint Computer Conference, 1967, https://doi.org/10.1145/1465482.1465560
[4] J. L. Gustafson, “Reevaluating Amdahl’s law”, Communications of the ACM, 1988, https://doi.org/10.1145/42411.42415
[5] 田浦健次朗, 並列分散プログラミング 講義資料 “Introduction”, https://taura.github.io/parallel-distributed-programming/slides/intro.pdf
[6] NVIDIA, “NVIDIA GH200 Grace Hopper Superchip Datasheet”, 2024, https://www.nvidia.com/en-us/data-center/grace-hopper-superchip/
[7] Daniels220, “AmdahlsLaw.svg”, Wikimedia Commons, CC BY-SA 3.0, https://commons.wikimedia.org/wiki/File:AmdahlsLaw.svg

[8] Peahihawaii, “Gustafson.png”, Wikimedia Commons, CC BY-SA 3.0, https://commons.wikimedia.org/wiki/File:Gustafson.png

[9] Wikipedia, “Grace Hopper GH200”, https://en.wikipedia.org/wiki/Grace_Hopper_GH200
[10] NVIDIA, “CUDA C++ Programming Guide (v12.4), 4.1 SIMT Architecture”, https://docs.nvidia.com/cuda/archive/12.4.0/cuda-c-programming-guide/index.html#simt-architecture